
 Về Chima Việt Nam
 Tất Cả Sản phẩm
 Màn Hình Quảng Cáo
 Thiết Bị - Vật Tư Thông Minh
 Máy Cắt - Khắc Laser
 Máy In 3D
 Thiết Bị Truyền Động
 Máy Công Cụ
 Máy Game Siêu Thị - Khu Vui Chơi
 Máy Đo Kiểm
 Điều Khiển Công Nghiệp
 Nguồn Điện DC
 Thiết Bị Cảm Biến
 Dây Chuyền/Máy Chế Biến Thực Phẩm
 Cổng An Ninh Kiểm Soát Ra Vào
 Thiết Bị IoT
 Máy Làm Sạch Bằng Laser
 Màn Hình Di Động
 Thiết Bị Hãng Perfect Laser
 Máy CNC
 Dụng Cụ Cầm Tay
 Van Công Nghiệp
 Dụng Cụ Đo Kiểm
 Máy Ép Nhựa
 Linh Kiện Máy
 Linh Kiện Cắt - Gọt
 Dụng Cụ Điện
 Xi Lanh
 Động Cơ Máy
 Linh Kiện Máy Hàn
 Thiết Bị WiFi
 Hệ Thống Tự Động Hoá
 Dây Chuyền Sản Xuất
 Bộ Lưu Điện UPS
 Hệ Thống Băng Tải
 Thiết Bị Điện Cao Áp


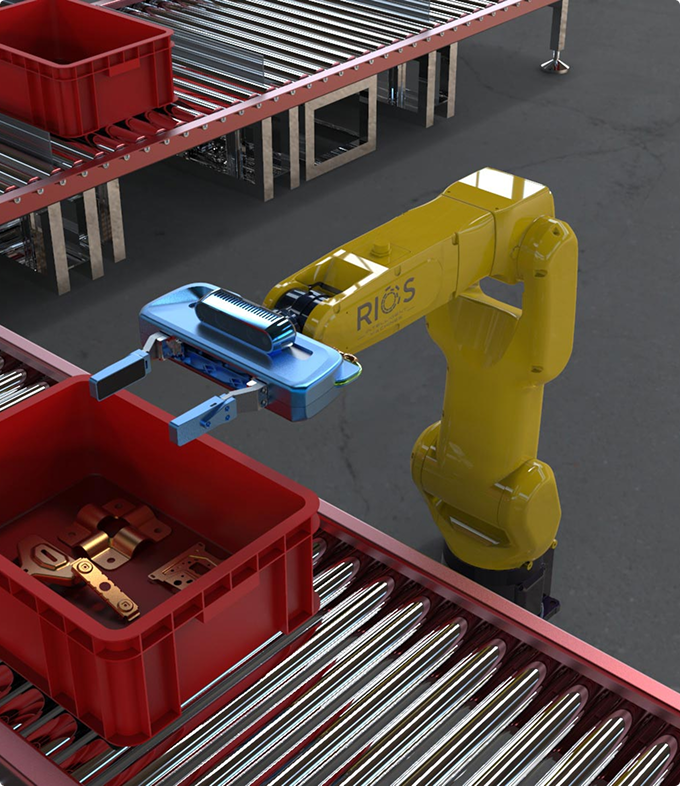
Robot muốn tương tác linh hoạt với thế giới vật lý cần nhiều hơn ảnh 2D. 3D robotic perception bổ sung thông tin chiều sâu để hệ thống ước lượng khoảng cách, hình học, vị trí và pose của vật thể; từ đó hỗ trợ pick & place, bin picking, machine tending, navigation và manipulation.
Depth camera chỉ là sensing layer. Hệ thống hoàn chỉnh vẫn cần calibration, perception software, coordinate transform, motion/grasp planning, robot controller và safety architecture.
Flow: RGB / Depth Sensor → 3D Perception → Object / Pose Estimation → Coordinate Transform → Motion Planning → Robot Controller → Physical Action
Đó là search intent cốt lõi của bài này: robot cần depth perception và 3D sensing như thế nào để chuyển từ việc chỉ nhìn ảnh sang hiểu vị trí, chiều sâu, pose và không gian để hành động.

Machine Vision và Robotic Perception khác nhau ở đâu?
Machine Vision trong nhà máy thường được tối ưu cho một câu hỏi hẹp và có điều kiện kiểm soát: sản phẩm có đúng không, có lỗi không, kích thước có nằm trong giới hạn không, mã có đọc được không. Output thường là PASS/FAIL, giá trị đo hoặc tọa độ trên ảnh.
Robotic perception rộng hơn ở chỗ kết quả quan sát phải đi vào quyết định hành động. Robot không chỉ cần biết “đây là chi tiết A”, mà còn cần biết chi tiết A nằm ở đâu, cách robot bao xa, đang xoay như thế nào, có bị che khuất không, có thể tiếp cận theo hướng nào và grasp nào ít rủi ro va chạm hơn. Vì vậy perception liên quan chặt tới localization, pose estimation, coordinate transform và planning.
Phần về inspection, defect detection, OCR và measurement đã được tách riêng trong bài AI và 3D Machine Vision trong nhà máy. Bài hiện tại tập trung vào perception-to-action.
Vì sao chiều sâu quan trọng?
Ảnh 2D biểu diễn tốt hai trục trên mặt phẳng ảnh: X và Y. Nhưng robot thao tác trong không gian vật lý cần thêm trục Z, tức khoảng cách theo chiều sâu. Một vật thể có thể xuất hiện ở cùng vị trí pixel nhưng thực tế ở hai khoảng cách khác nhau; hoặc hai chi tiết có hình chiếu 2D gần giống nhau nhưng nằm ở các cao độ khác nhau trong bin.
Depth không tự động giải quyết mọi bài toán, nhưng nó bổ sung thông tin hình học để phần mềm xây dựng biểu diễn 3D của scene, ước lượng khoảng cách, tách foreground/background, xác định bề mặt và hỗ trợ pose estimation.
Depth Map là gì?
Depth map là một ảnh trong đó mỗi pixel mang giá trị biểu diễn khoảng cách tới bề mặt quan sát được theo mô hình của cảm biến. Khi hiển thị cho người, depth map thường được tô màu hoặc chuyển sang grayscale để khoảng cách gần/xa dễ nhìn; nhưng giá trị kỹ thuật quan trọng là trường độ sâu gắn với vị trí pixel.
Depth map không phải point cloud. Nó vẫn có cấu trúc giống ảnh 2D, chỉ thay cường độ màu bằng thông tin chiều sâu. Khi kết hợp depth với camera intrinsics và phép chiếu phù hợp, hệ thống có thể chuyển các pixel hợp lệ thành điểm 3D.
Point Cloud là gì?
Point cloud là tập hợp các điểm trong không gian, thường có tọa độ X/Y/Z và có thể kèm màu, intensity, confidence hoặc metadata tùy sensor. Đám mây điểm cho phép thuật toán làm việc trực tiếp với hình học 3D: mặt phẳng, cạnh, cụm vật thể, bề mặt, khoảng trống và tương quan không gian.
Trong robot, point cloud có thể dùng cho segmentation, object localization, pose estimation, collision checking, bin picking, mapping hoặc sensor fusion. Tuy nhiên “nhiều điểm hơn” không đồng nghĩa hệ thống tốt hơn; chất lượng dữ liệu phụ thuộc công nghệ đo, bề mặt, lighting, occlusion, working distance, calibration và pipeline lọc.

Các công nghệ đo chiều sâu
Không có một nguyên lý sensing luôn tốt nhất. Stereo suy ra chiều sâu từ disparity giữa hai góc nhìn; active stereo bổ sung pattern/illumination chủ động để tăng texture cho bài toán matching; structured light chiếu mẫu đã biết lên scene; ToF ước lượng khoảng cách từ thời gian hoặc pha của tín hiệu ánh sáng; LiDAR đo khoảng cách bằng laser theo kiến trúc quét hoặc solid-state khác nhau; còn sensor fusion kết hợp nhiều nguồn để tận dụng thế mạnh bổ sung.
Chọn nguyên lý phải bắt đầu từ working distance, FOV, surface, lighting, motion, môi trường, kích thước vật thể, yêu cầu depth, compute và cách sensor gắn trên robot. Spec của từng model phải được đối chiếu từ datasheet tại thời điểm thiết kế thay vì suy diễn từ tên công nghệ.
6 lớp của một hệ 3D Robotic Perception
- Image / Depth Acquisition: thu RGB, depth hoặc dữ liệu 3D từ sensor với thời gian và exposure phù hợp.
- Calibration: xác định camera intrinsics, distortion và quan hệ hình học giữa sensor với robot/workcell.
- Perception: lọc dữ liệu, segmentation, detection, model matching, point-cloud processing và pose estimation.
- Coordinate Transformation: chuyển kết quả từ Camera Frame sang Robot Base/Tool/Workpiece Frame.
- Motion / Grasp Planning: chọn grasp, kiểm tra reachability/collision, tạo trajectory hoặc sequence.
- Robot Execution: controller thực thi motion, I/O và handshake với gripper, PLC, machine controller và safety system.
Một ví dụ phần mềm mới đáng chú ý trong 72 giờ gần nhất là Intrinsic Core, được Intrinsic công bố tại ROSCon 2026 ngày 22/09/2026. Intrinsic mô tả Core là bộ capability mã nguồn mở, ROS-compatible, gồm perception, sensor-based control, motion và grasp planning, digital twin, camera calibration và hardware-agnostic real-time control. Đây là evidence cho xu hướng ghép perception và planning thành một stack hoàn chỉnh; không phải sản phẩm Chima và không đồng nghĩa đã được triển khai tại Việt Nam.
Calibration: nhận đúng object vẫn có thể gắp sai
Robot cell có nhiều hệ tọa độ. Camera Frame mô tả điểm theo sensor; Robot Base Frame là hệ quy chiếu của robot; Tool Frame gắn với TCP hoặc end-effector; Workpiece Frame gắn với fixture, pallet, machine hoặc part reference.
Calibration xác định các phép biến đổi cần thiết giữa các frame. Với camera cố định, thường phải biết transform giữa camera và robot base/workcell. Với eye-in-hand, cần biết transform giữa camera và tool, đồng thời theo dõi pose của tool theo robot kinematics.
Nhận dạng đúng object nhưng calibration sai thì robot vẫn đi sai vị trí. Đây là lý do calibration không phải bước setup một lần rồi quên: thay camera, va chạm, thay tool, nới gá, thay lens hoặc thay mounting có thể làm transform không còn đúng.
Pose Estimation: robot cần biết cả position và orientation
Object detection trả lời “vật thể ở đâu trên ảnh” chưa đủ cho nhiều thao tác. Robot thường cần position 3D và orientation. Khi bài toán yêu cầu đầy đủ ba bậc tự do tịnh tiến và ba bậc tự do quay, người ta thường gọi là 6D/6-DoF pose.
Pose có thể đến từ model-based geometry, point cloud alignment, keypoints, learned pose estimation hoặc pipeline kết hợp. Intrinsic Core hiện mô tả capability pose estimation 3D cùng motion và grasp planning; RealSense cũng định vị depth sensing cho robotic perception. Bài này không gán accuracy cho bất kỳ stack nào vì accuracy phụ thuộc sensor, object, surface, viewpoint, calibration và thuật toán.
Fixed Camera vs Eye-in-Hand
Fixed camera có lợi thế quan sát vùng làm việc ổn định, dây cáp đơn giản hơn và không tăng khối lượng ở cổ tay robot. Nhưng occlusion có thể tăng khi robot, gripper hoặc thành bin che vật thể; FOV phải đủ bao phủ toàn workspace.
Eye-in-hand đưa camera gần tool, cho phép đổi viewpoint theo chuyển động và quan sát gần điểm tương tác. Đổi lại, cable routing, rung động, payload, near-field, thời gian robot dành cho bước “nhìn”, và hand-eye calibration trở thành phần thiết kế quan trọng hơn.
Không có cấu hình nào luôn tốt hơn. Nhiều cell còn dùng multi-camera hoặc kết hợp camera cố định với camera ở tool khi use case cần.

Random Bin Picking: depth chỉ là bước đầu
Capture → Detect Part → Estimate Pose → Select Grasp → Plan Motion → Pick
Trong bin picking, vật thể thường chồng lấp, quay ngẫu nhiên và có occlusion. Depth giúp phần mềm xây geometry của scene; detection/segmentation tìm part candidate; pose estimation xác định vị trí/hướng; grasp planner đánh giá điểm gắp; motion planner kiểm tra quỹ đạo và collision; robot controller mới thực hiện thao tác.
RealSense hiện mô tả 3D robotic perception cho fixed-arm perception-guided robotics, AMR, quadruped và humanoid; trang Industrial Automation của hãng cũng nêu bin picking, pose estimation và camera-on-robot là các use case. Các claim hiệu năng cụ thể của một model không được dùng ở đây vì cần kiểm chứng theo đúng sensor, setup và điều kiện cell.
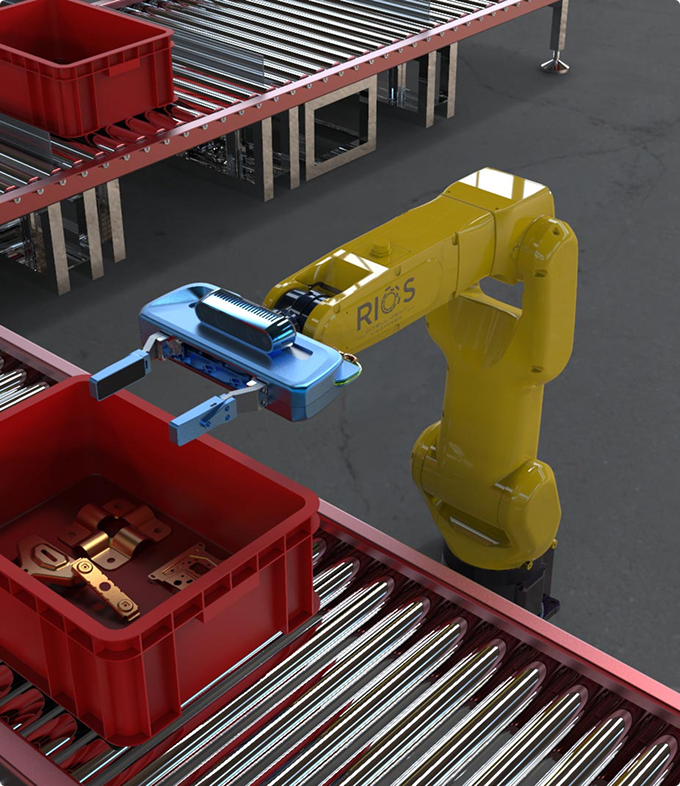
Machine Tending: giảm phụ thuộc hard fixture trong một số use case high-mix
Machine tending truyền thống thường dựa nhiều vào khay, fixture, stopper hoặc indexing để đảm bảo phôi xuất hiện ở vị trí robot đã biết. 3D perception có thể giảm một phần phụ thuộc này trong một số use case high-mix bằng cách định vị phôi theo scene thực thay vì giả định vị trí cố định.
Điều đó không có nghĩa “3D Vision loại bỏ fixture”. Fixture vẫn có giá trị cho process stability, orientation, repeatability, protection, loading và metrology. Kiến trúc phù hợp là dùng perception khi variation đủ lớn để tạo ROI, còn cơ khí vẫn giữ các điểm cần deterministic.
Thông tin mới tại ROSCon 2026 cũng củng cố hướng này: Intrinsic công bố Open Machine Tending Solution như một reference solution xây trên Intrinsic Core và ROS, kèm camera calibration, pose estimation, motion planning và grasping. Đây là ví dụ về cách perception được nối trực tiếp với planning thay vì tồn tại như một camera tách rời.
AMR: depth camera là một phần của sensor stack
AMR có thể kết hợp depth camera, LiDAR, RGB camera, IMU và encoder. Mỗi sensor trả một loại thông tin khác nhau: depth cho geometry gần/trung bình và obstacle shape; LiDAR hữu ích cho ranging, mapping và SLAM theo thiết kế; RGB bổ sung texture/semantic; IMU ước lượng chuyển động; encoder hỗ trợ odometry.
Sensor fusion không có nghĩa cộng tất cả sensor một cách cơ học. Hệ thống phải xử lý timestamp, coordinate frames, drift, uncertainty, failover và compute budget. Phần sâu về fleet và logistics nội bộ có tại bài robot AMR trong logistics nội bộ.
Navigation/perception sensor ≠ safety-rated sensor. Camera hoặc LiDAR dùng cho SLAM, obstacle detection hay perception không mặc nhiên đáp ứng yêu cầu của một safety function. Nếu sensor tham gia safety, capability, diagnostic, failure mode, response time, architecture và chứng nhận phải được đánh giá riêng theo risk assessment và yêu cầu ứng dụng.

Humanoid: perception stack phải hiểu nhiều loại thực thể cùng lúc
Humanoid hoặc robot chân/quadruped phải xử lý viewpoint thay đổi theo body motion và self-occlusion. Perception stack có thể cần nhận biết floor, obstacle, human, container, machine, tool và manipulation object; đồng thời ước lượng state của chính robot để liên hệ sensor data với world frame.
Depth camera phù hợp với nhiều bài toán gần và trung bình, đặc biệt khi robot cần geometry cho manipulation. LiDAR có thể bổ sung ranging, mapping hoặc SLAM. RGB hỗ trợ semantic understanding; IMU và joint encoders giúp theo dõi body motion. Phần chuyên sâu về sensor placement và SLAM cho humanoid đã được phân tích trong bài LiDAR và nhận thức 3D cho robot hình người.
Không nên suy diễn rằng humanoid đã phổ biến trong nhà máy Việt Nam. Với doanh nghiệp Việt, hợp lý hơn là đánh giá workflow cụ thể, variation, safety boundary và ROI trước khi chọn morphology robot.
Depth Camera vs LiDAR: không phải cuộc đối đầu một-mất-một-còn
Depth camera thường cung cấp dense depth trong FOV dạng camera và phù hợp cho close/mid-range manipulation, hand-eye, bin picking, object geometry hoặc semantic + depth khi có RGB. LiDAR mạnh ở ranging, mapping, SLAM và spatial coverage theo thiết kế của từng sensor.
Range, angular resolution, point pattern, FOV, lighting sensitivity, surface response, moving parts, size, power và interface thay đổi lớn giữa các model. Vì vậy không nên nói “Depth Camera luôn tốt hơn LiDAR” hoặc ngược lại. Nhiều robot hiệu quả nhất khi dùng sensor fusion để kết hợp geometry gần, coverage rộng, inertial state và semantic cues.
2D vs 3D Vision: không phải bài toán nào cũng cần 3D
Nếu part luôn nằm trên một mặt phẳng kiểm soát, chiều sâu không biến thiên và robot chỉ cần X/Y cùng góc quay trong mặt phẳng, 2D Vision thường đơn giản hơn về optics, calibration, compute và commissioning.
3D trở nên đáng giá khi Z là biến quan trọng: nhiều cao độ, part chồng lấp, bin picking, grasping từ scene lộn xộn, obstacle geometry hoặc pose ngoài mặt phẳng. Chọn 3D chỉ vì “mới hơn” có thể làm cell phức tạp mà không tạo thêm giá trị.
Depth Camera vs Metrology: đừng nhầm perception với đo lường cấp metrology
Robotic depth perception không mặc nhiên thay được CMM/3D scanner metrology. Measurement-grade system có yêu cầu riêng về accuracy, repeatability, traceability, uncertainty, calibration, environment và acceptance criteria.
Depth camera có thể cung cấp metric geometry đủ cho nhiều bài toán manipulation hoặc spatial awareness, nhưng nếu yêu cầu là xác nhận kích thước/gd&t theo tiêu chí chất lượng, hệ đo phải được chọn và xác minh như một hệ metrology. Phần này được tách riêng khỏi search intent của bài để tránh cannibalization với AI-Ready Quality.
Edge AI nằm ở đâu trong perception stack?
Compute có thể nằm trong smart camera, vision controller, robot computer hoặc Industrial PC. Smart camera giảm data transfer nếu chỉ cần trả pose/result; vision controller gom nhiều camera; robot computer thuận tiện khi perception gắn chặt với robot software; Industrial PC phù hợp khi cần GPU/NPU, nhiều interface, logging, middleware hoặc tách vòng đời AI software khỏi robot controller.
Điểm cần thiết kế là data path, bandwidth, latency budget, deterministic boundary, update strategy và failure behavior. Edge AI là nơi chạy compute, không phải định nghĩa của robotic perception. Phần kiến trúc controller/tool flange/compute cho cobot đã được tách ở bài kiến trúc cobot AI-ready.
Visual Intelligence Stack: từ “nhìn” đến “hành động”
Identify → Inspect → Measure → Perceive → Localize → Plan → Act
Chuỗi này giúp phân biệt các lớp giá trị. Identify xác định ID/class; Inspect kiểm tra chất lượng; Measure tạo đại lượng hình học; Perceive xây hiểu biết về scene; Localize xác định vật thể/robot trong frame; Plan chọn grasp/path/sequence; Act mới là bước robot tác động lên thế giới vật lý.
Thông tin mới ngày 22/09/2026 làm bức tranh này rõ hơn. Cognex đã ký thỏa thuận mua RealSense theo definitive agreement; giao dịch chưa được công bố là hoàn tất và dự kiến close trong Q4/2026, subject to customary closing conditions. Cognex mô tả logic chiến lược là mở rộng từ industrial ID, 2D/3D machine vision measurement sang 3D depth perception và robotic navigation. RealSense được nêu với ứng dụng fixed-arm perception-guided robotics, AMR, quadruped và humanoid.
Theo thông cáo chính thức, giá trị giao dịch khoảng 500 triệu USD. Cognex cũng đưa ra ước tính của Cognex về robotic perception market khoảng 600 triệu USD hiện tại và khoảng 1,6 tỷ USD năm 2030 với tăng trưởng hơn 25%/năm. Đây là market estimate của bên công bố, không phải fact độc lập và không được dùng để suy ra quy mô thị trường Việt Nam.
Để nhìn bức tranh rộng hơn về sensing–AI–action trong sản xuất, xem Physical AI trong nhà máy.
Use cases 3D Robotic Perception tại Việt Nam
1. Random Bin Picking
Chi tiết nằm ngẫu nhiên trong thùng, chồng lấp và thay đổi orientation. Pipeline cần depth/point cloud, segmentation, pose, grasp và collision-aware motion thay vì chỉ detection 2D.
2. CNC Machine Tending
3D perception có thể giúp robot định vị phôi/chi tiết có variation, xác nhận vị trí trước load/unload và giảm phụ thuộc hard fixture trong một số workflow high-mix. Handshake với cửa, chuck, CNC cycle và safety vẫn là lớp riêng.
3. Palletizing / Depalletizing
Depth hỗ trợ ước lượng cao độ, mặt trên, khoảng trống và pose của thùng/tote khi stack không hoàn toàn đồng đều. Gripper và motion strategy phải được thiết kế theo vật liệu, trọng lượng và độ ổn định tải.
4. AMR / Warehouse Robotics
Depth camera có thể bổ sung obstacle geometry, docking, pallet perception hoặc close-range navigation, thường phối hợp với LiDAR, IMU, encoder và RGB tùy robot. Phần fleet orchestration nằm ngoài phạm vi perception.
5. Flexible Assembly
3D Vision đưa robot tới vùng lắp khi part position/orientation biến thiên; bước cuối có thể cần force/torque sensing hoặc compliance nếu insertion/contact là biến quan trọng.
Roadmap chọn kiến trúc
Task → Variation → Need for Depth → Sensor Principle → Camera Placement → Calibration → Perception Benchmark → Motion Integration → Safety → Pilot
Bắt đầu từ task thật, không bắt đầu từ camera. Thu thập variation thật, xác định Z/pose nào robot cần, sau đó mới chọn nguyên lý sensor và placement. Benchmark perception phải tách rõ detection, pose, failure cases và lost-depth conditions; motion integration phải test với workspace và collision thật. Safety được thiết kế song song, không phải lớp vá sau cùng.
Checklist 18 câu hỏi trước khi chọn Depth Camera cho robot
- Working distance nhỏ nhất và lớn nhất thực tế là bao nhiêu?
- FOV cần bao phủ toàn bin/workspace hay chỉ vùng thao tác?
- Kích thước vật thể và feature nhỏ nhất cần nhìn là gì?
- Surface là matte, bóng, đen, trong, kim loại hay hỗn hợp?
- Lighting môi trường ổn định hay thay đổi theo ca/cửa sổ?
- Occlusion chính đến từ thành bin, robot, gripper hay part chồng lấp?
- Camera fixed hay eye-in-hand, và vì sao?
- Có cần RGB cho semantic/texture hay chỉ depth?
- Depth requirement là khoảng cách, height map, point cloud hay dense geometry?
- Robot cần 2D position, 3D position hay full 6D pose?
- Cycle time cho phép bao nhiêu bước capture/reposition?
- Compute đặt ở camera, controller, robot computer hay Industrial PC?
- Robot interface là TCP/IP, ROS/ROS 2, fieldbus hay vendor API?
- Calibration được tạo, kiểm tra và bảo trì như thế nào?
- Khi camera bị che, mất depth hoặc pose không chắc chắn, robot làm gì?
- Grasp planning dùng rule, model, CAD hay learned approach?
- Sensor perception có bị nhầm với safety sensor không?
- Pilot có đủ part variation, lighting, bin fill level và failure cases chưa?
FAQ
Depth Camera là gì?
Depth camera là camera/sensor tạo dữ liệu khoảng cách theo pixel hoặc theo cấu trúc 3D, giúp phần mềm suy ra geometry và vị trí trong không gian. Nguyên lý có thể là stereo, active stereo, structured light, ToF hoặc kiến trúc khác tùy sản phẩm.
3D Vision có bắt buộc cho robot không?
Không. Nếu robot làm việc với fixture ổn định và chỉ cần tọa độ trên mặt phẳng, 2D Vision hoặc thậm chí không cần vision có thể đủ. 3D đáng dùng khi depth, height hoặc orientation không gian là biến quan trọng.
Depth Camera và LiDAR khác nhau thế nào?
Depth camera thường tạo dense depth theo FOV camera, phù hợp nhiều bài toán manipulation và close/mid-range perception. LiDAR thường được dùng mạnh cho ranging, mapping và SLAM. Cấu hình tốt phụ thuộc range, FOV, point density, surface, môi trường và use case; hai loại có thể bổ sung nhau.
3D Vision có thay 2D Vision không?
Không. 2D vẫn đơn giản và hiệu quả khi chiều sâu không phải biến. Nhiều cell kết hợp 2D cho barcode/OCR/appearance và 3D cho geometry/pose.
Depth Camera có dùng cho AMR không?
Có thể. Depth camera có thể hỗ trợ obstacle perception, docking, pallet detection, VSLAM hoặc close-range geometry tùy architecture. Nhiều AMR vẫn kết hợp LiDAR, IMU, encoder và các sensor khác.
Camera AI có thể dùng làm safety sensor không?
Không nên mặc định như vậy. Perception camera có thể phát hiện người/vật thể nhưng không mặc nhiên là safety-rated. Safety function cần sensor/architecture đáp ứng requirement, diagnostic, failure response, validation và chứng nhận phù hợp.
CTA: gửi đúng dữ liệu để chọn đúng kiến trúc perception
Nếu doanh nghiệp đang xây robot cell, hãy gửi cho Chima: use case robot, part, kích thước, working distance, FOV, surface, indoor/outdoor, cycle time, robot controller, camera placement dự kiến và output requirement.
Chima có thể hỗ trợ đối chiếu kiến trúc 2D/3D Machine Vision, LiDAR, depth/3D sensing khi danh mục phù hợp, Industrial PC, cảm biến và automation components. Việc chọn sensor cần dựa trên use case và benchmark; Chima không mặc định camera perception là safety sensor, không guarantee pose accuracy khi chưa test hệ thực tế và không claim cung cấp RealSense/Cognex khi chưa được xác minh trong danh mục.
Nguồn kỹ thuật đã kiểm tra
- Cognex Investor Relations — Cognex to Acquire RealSense, 22/09/2026.
- RealSense — Cognex to Acquire RealSense, 22/09/2026.
- Intrinsic — Introducing Intrinsic Core, 22/09/2026.
- Intrinsic Core — ROS-compatible capabilities, perception, pose estimation, calibration, motion và grasp planning.
- RealSense — Industrial Automation / Vision-Guided Robotics.
- RealSense Developer Documentation — depth, point cloud và coordinate transforms.
Cập nhật research: 23/09/2026. Trạng thái thương vụ Cognex–RealSense được kiểm tra theo thông cáo ngày 22/09/2026: đã ký thỏa thuận mua, chưa mô tả là completed acquisition.


Viết bình luận